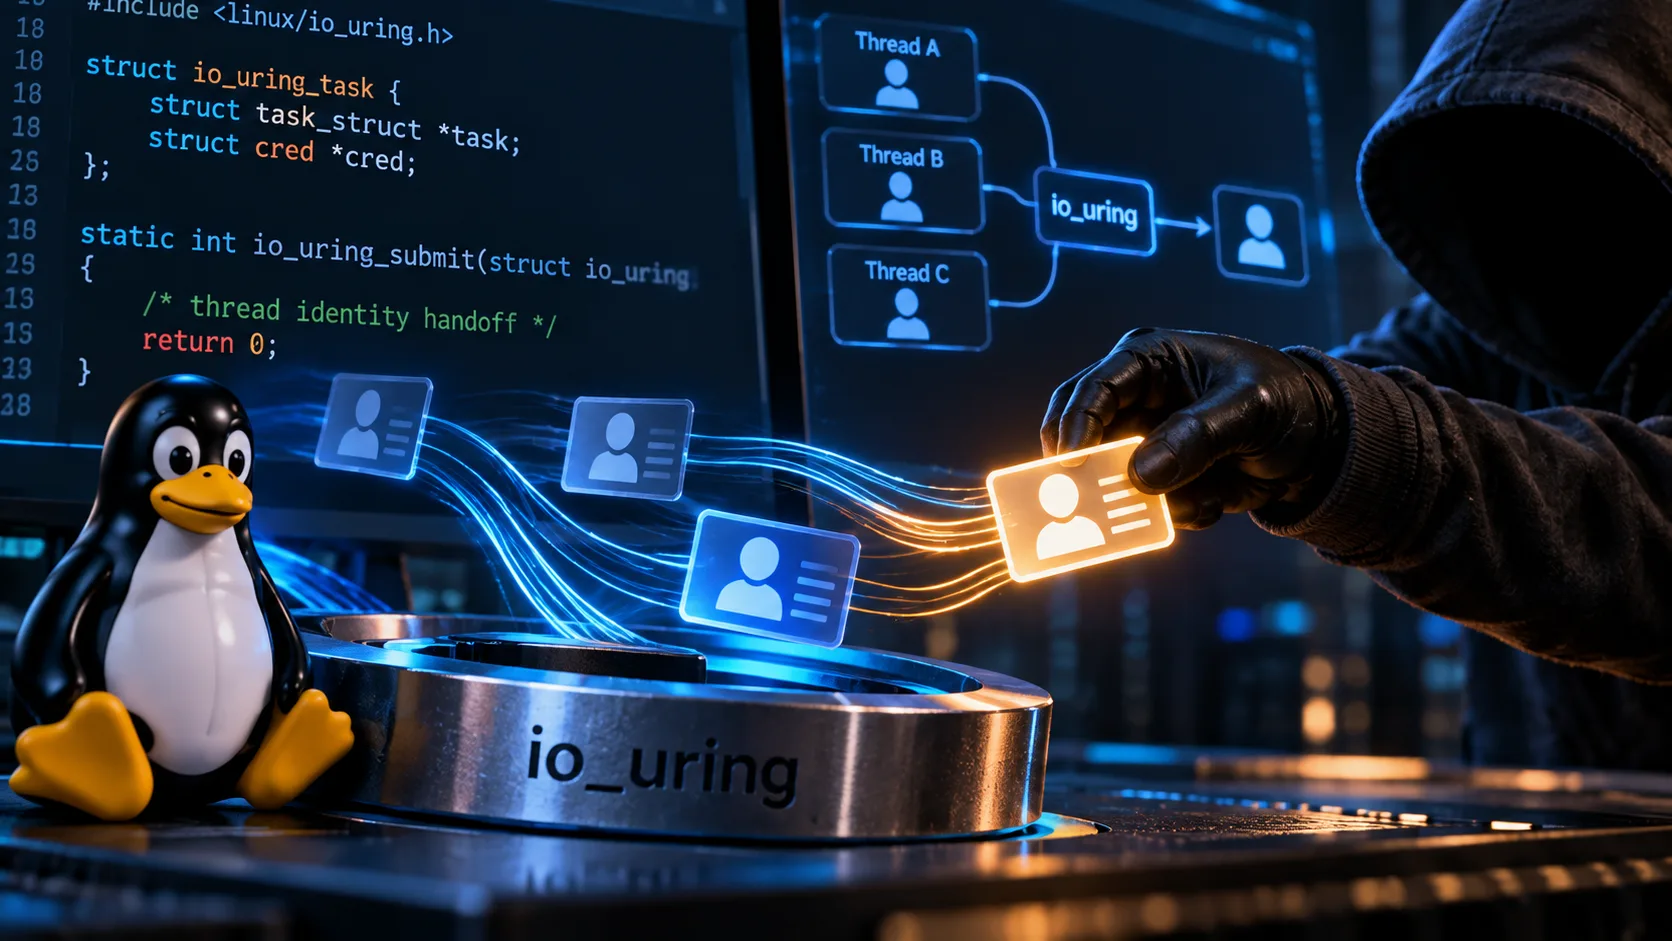
Jens Axboe, mantenedor e criador do subsistema de I/O assíncrono, enviou o patch definitivo, mergeado nesta semana por Linus Torvalds, que introduz filtros de segurança baseados em Classic BPF (cBPF) para o io_uring. A mudança resolve um impasse histórico entre performance e segurança, permitindo finalmente que sistemas de contenção (como Docker, Kubernetes e systemd) restrinjam operações do io_uring sem precisar desabilitá-lo completamente.
O que isso significa na prática:
Imagine que o io_uring é um serviço de entregas ultra-rápido que entra no prédio (Kernel) sem passar pela portaria principal (seccomp). Antes, por segurança, administradores de sistemas trancavam esse serviço do lado de fora porque não conseguiam ver o que estava sendo entregue, forçando os aplicativos a usarem métodos mais lentos.
Com essa mudança, cria-se um “raio-x” na entrada desse serviço. O sistema agora pode dizer: “Você pode usar o serviço rápido para entregar cartas (ler arquivos), mas está proibido de entregar pacotes pesados (abrir conexões de rede)”. Isso libera o desempenho do io_uring para uso seguro em ambientes compartilhados.
Detalhes da implementação
O conflito principal residia na arquitetura do seccomp, que filtra chamadas de sistema (syscalls), e do io_uring, que opera através de anéis de submissão (SQ rings) na memória compartilhada, muitas vezes contornando a inspeção tradicional do seccomp.
A solução implementada no Kernel Linux introduz:
- Filtros cBPF específicos: Permite registrar programas cBPF que inspecionam o
opcode(o comando) do io_uring. Ao contrário do eBPF (que é mais complexo e frequentemente bloqueado em containers), o cBPF é mais simples e seguro para este contexto. - Inspeção Post-Init: O filtro roda após a inicialização da requisição e a cópia dos dados do espaço de usuário para o kernel. Isso é crucial para evitar ataques do tipo TOCTOU (Time-of-Check to Time-of-Use), onde um atacante poderia alterar o comando na memória depois da verificação de segurança, mas antes da execução.
- Herança de restrições: Tarefas que criam anéis herdam as restrições da tarefa pai. Uma vez definida uma restrição, ela não pode ser relaxada, apenas apertada.
Tabela: Capacidade de filtragem (Antes vs depois)
| Recurso | Antes do patch | Com Linux 6.19 (Novo) |
| Controle de Opcode | Tudo ou nada (Binário) | Granular (Permite/Nega por comando) |
| Contexto de rede | Invisível para filtros | Filtra Domínio, Tipo e Protocolo (IORING_OP_SOCKET) |
| Abertura de arquivos | Invisível para filtros | Filtra Flags e Modos (IORING_OP_OPENAT) |
| Compatibilidade | Bloqueado por padrão em Containers | Habilitável com regras seguras |
Quando isso chega no meu PC?
O patch foi mergeado na árvore principal (linux.git master) durante a janela de desenvolvimento de Fevereiro de 2026.
- Desenvolvimento: O código já está no Kernel Mainline.
- Versão estável: Deve ser lançado oficialmente no Linux 6.19 (previsto para Abril/2026).
- Distribuições: Usuários de distros “Rolling Release” (Arch, openSUSE Tumbleweed) receberão logo após o lançamento. Distros estáveis (Ubuntu 26.04 LTS, Fedora 44) devem incorporar o suporte via backport ou na próxima atualização de kernel HWE.