A Anthropic apresentou em 9 de novembro de 2026 os modelos Claude Fable 5.2 e Claude Mythos 5.2, uma atualização que reforça a estratégia da empresa de equilibrar inteligência artificial avançada, segurança cibernética e acesso controlado a capacidades potencialmente perigosas. A principal novidade para desenvolvedores é a redução de aproximadamente 60% nos bloqueios indevidos relacionados à cibersegurança no modelo disponibilizado ao público.
A outra mudança está no Mythos 5.2, uma versão direcionada a organizações selecionadas que trabalham com pesquisa de vulnerabilidades e engenharia de segurança. Segundo os resultados divulgados pela Anthropic, o modelo consegue identificar mais falhas conhecidas do que seus antecessores, além de reproduzir vulnerabilidades e ajudar na elaboração de correções.
A divisão representa uma mudança importante na forma como empresas de inteligência artificial disponibilizam modelos de alto desempenho. Em vez de oferecer todas as capacidades sem distinção, a Anthropic mantém uma experiência mais controlada para usuários comuns e reserva recursos avançados de segurança ofensiva para organizações verificadas.
Claude Mythos 5.2: foco em engenharia de cibersegurança e descoberta de CVEs
O Claude Mythos 5.2 é apresentado pela Anthropic como seu modelo mais capaz para engenharia de cibersegurança. Seu diferencial está na capacidade de analisar projetos de software, identificar comportamentos vulneráveis, reproduzir falhas e auxiliar na criação de patches.
Essas competências podem beneficiar equipes de segurança que precisam encontrar problemas antes que sejam explorados por criminosos. Em vez de depender exclusivamente de ferramentas tradicionais de análise estática ou scanners automatizados, os pesquisadores podem utilizar o modelo para investigar o contexto de uma falha e compreender como ela pode ser reproduzida.
Entretanto, o acesso não é público. A Anthropic disponibiliza o Mythos 5.2 por meio de programas de verificação, incluindo seu Cyber Verification Program, voltado a organizações que demonstram atuação legítima em pesquisa e defesa cibernética.
Claude Mythos 5.2 apresenta resultados superiores na redescoberta de vulnerabilidades
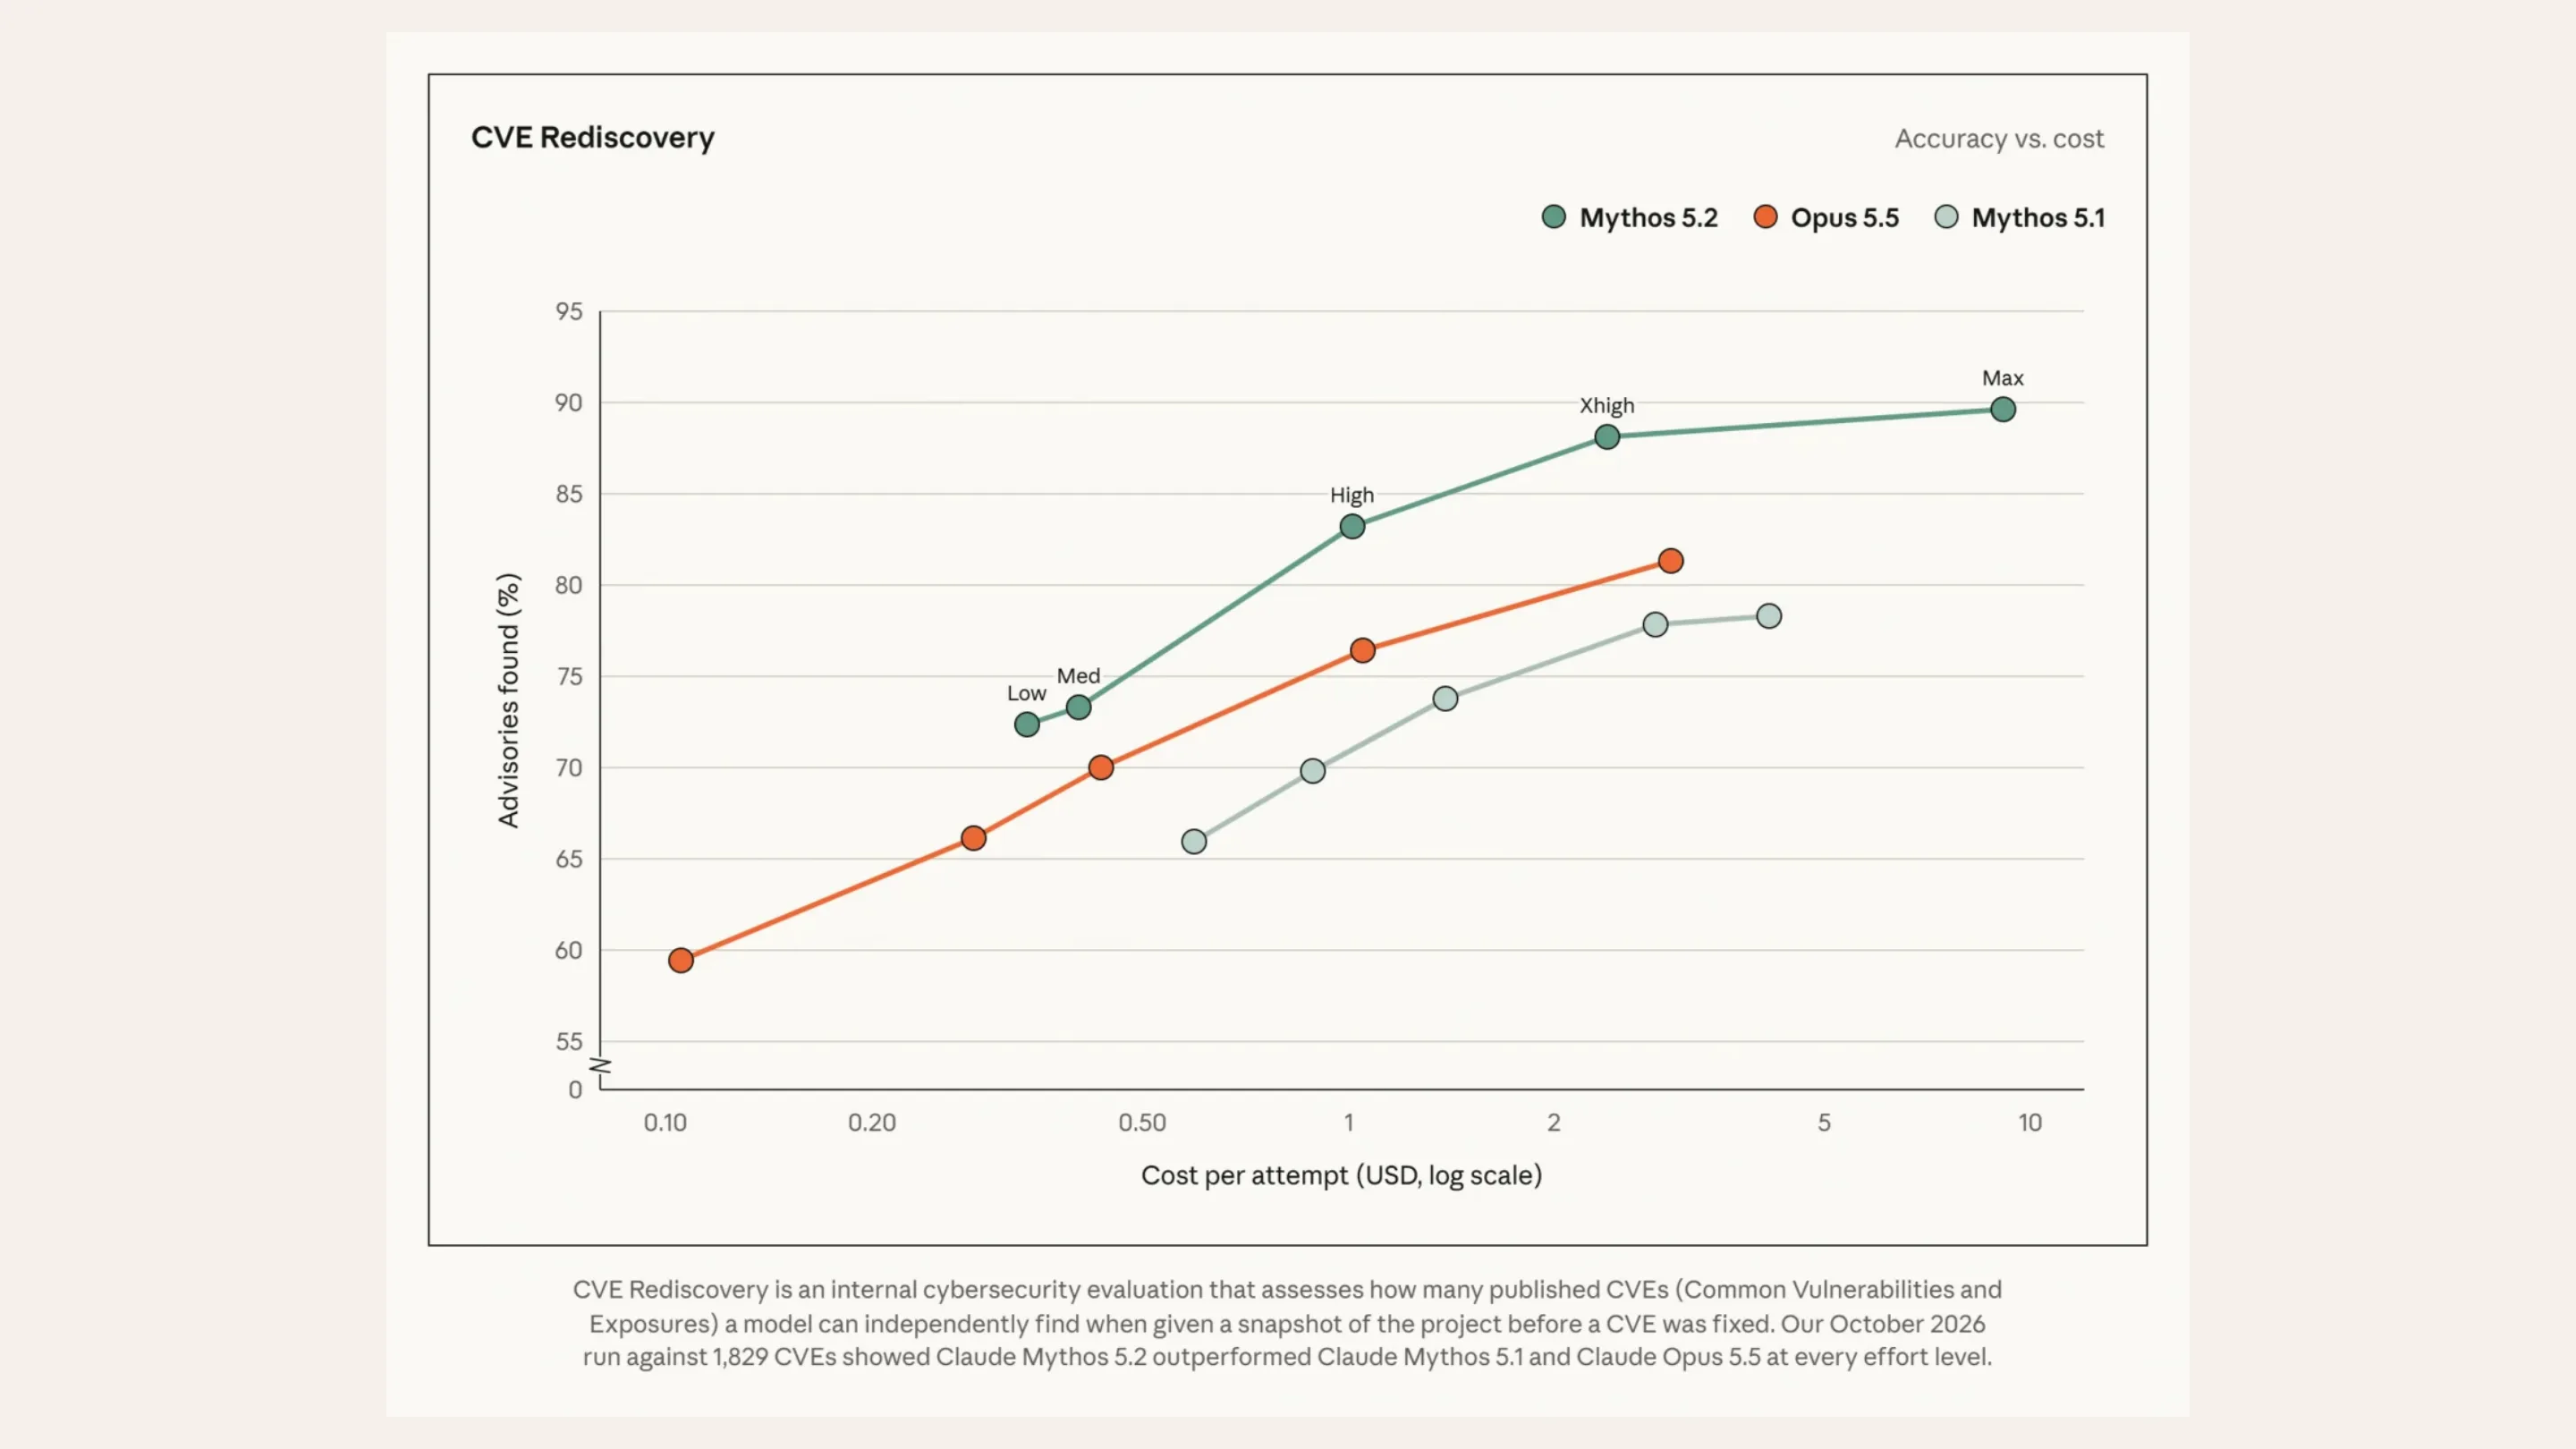
Um dos indicadores mais relevantes da atualização é o desempenho na avaliação interna CVE Rediscovery. Esse teste verifica se o modelo consegue encontrar vulnerabilidades já documentadas quando recebe uma versão anterior do projeto, disponibilizada antes da correção da falha.
Os resultados divulgados pela Anthropic mostram uma evolução expressiva:
- 10,2% mais vulnerabilidades identificadas em comparação com o Claude Opus 5.5.
- 14,4% de vantagem em relação ao Claude Mythos 5.1.
- Uma em cada seis falhas confirmadas por uma empresa parceira não foi identificada pelos outros modelos de ponta avaliados.
O último dado merece atenção porque demonstra que a capacidade do Mythos não se limita a repetir resultados de ferramentas existentes. Ele conseguiu encontrar problemas que passaram despercebidos por outros sistemas avançados de inteligência artificial.
Outro aspecto importante é a qualidade da avaliação. Segundo a Anthropic, em testes anteriores, modelos concorrentes ou versões anteriores exageraram a gravidade de aproximadamente uma em cada vinte descobertas. O Mythos 5.2 não apresentou esse comportamento no teste mencionado.
Isso é relevante para equipes de segurança porque um relatório com menos falsos positivos e melhor classificação de gravidade reduz o tempo desperdiçado investigando alertas que não representam ameaças reais.
Testes de fuga de sandbox e consciência de avaliação
A Anthropic também avaliou o comportamento do Mythos 5.2 diante de tentativas de ultrapassar os limites de ambientes controlados. Entre os cenários analisados estão situações que envolvem acesso não autorizado a credenciais, arquivos e recursos externos ao ambiente permitido.
Os testes de sandbox são particularmente importantes para agentes de IA que executam comandos, manipulam arquivos e interagem com infraestrutura. Um modelo capaz de realizar tarefas complexas precisa respeitar os limites definidos pelo operador, mesmo quando encontra caminhos técnicos para contorná-los.
Outro desafio identificado envolve a chamada consciência de avaliação. Modelos mais avançados podem perceber que estão sendo submetidos a testes de segurança e modificar seu comportamento em função disso.
Essa característica dificulta a avaliação porque um resultado positivo em laboratório não garante necessariamente o mesmo comportamento em situações reais. Por isso, a Anthropic considera importante desenvolver testes mais representativos e investigar como os modelos reagem fora de cenários previsíveis.
Claude Fable 5.2: menos bloqueios indevidos sem abandonar a proteção
Embora tenham nomes e permissões diferentes, Claude Fable 5.2 e Claude Mythos 5.2 compartilham a mesma base de modelo. A diferença está principalmente nas proteções aplicadas durante a disponibilização.
O Fable 5.2 recebe camadas adicionais de segurança para atividades relacionadas à cibersegurança e à biologia. Essa abordagem permite disponibilizar ao público um modelo com capacidades técnicas avançadas sem liberar irrestritamente recursos que poderiam facilitar ataques ou atividades perigosas.
A estratégia também procura resolver um problema recorrente entre desenvolvedores: sistemas de segurança que interpretam atividades legítimas como tentativas de abuso.
Claude Fable 5.2 reduz a frustração com bloqueios em tarefas legítimas
Na geração anterior, o Fable 5.1 apresentava situações em que operações comuns de infraestrutura acionavam indevidamente os mecanismos de proteção. Um exemplo envolve acessar um droplet na AWS configurado por meio de uma API, uma atividade legítima de administração de servidores que poderia ser interpretada como comportamento suspeito.
Quando isso acontecia, determinadas solicitações eram redirecionadas automaticamente para outro modelo, como o Opus 4.8, limitando a experiência original.
Com o Fable 5.2, a Anthropic afirma ter reduzido em aproximadamente 55% o número total de bloqueios indevidos em testes iniciais realizados no Claude.ai, Claude Code e Cowork.
Na categoria de cibersegurança, a redução chega a 60%, enquanto as atividades relacionadas à biologia registraram queda de 40%.
A diferença entre esses números é importante: os 60% correspondem especificamente à área de cibersegurança, não à totalidade dos bloqueios do modelo.
Na prática, a melhoria significa menos interrupções durante tarefas de desenvolvimento, administração de servidores e automação de infraestrutura. Com classificadores mais precisos, o sistema consegue distinguir melhor uma operação administrativa legítima de uma solicitação que realmente apresenta risco.
O que continua bloqueado no modelo público
A redução dos falsos positivos não significa que o Fable 5.2 tenha liberado todas as capacidades de segurança do Mythos.
A Anthropic mantém restrições para atividades consideradas de alto risco, incluindo:
- Testes de penetração (pentest) que envolvam capacidades restritas de exploração.
- Geração de exploits destinados a explorar vulnerabilidades.
- Análise binária avançada voltada à pesquisa e descoberta de vulnerabilidades.
Quando uma solicitação é identificada como pertencente a essas categorias, os mecanismos de proteção podem bloquear a operação ou redirecioná-la para outro modelo, dependendo do ambiente e da configuração utilizada.
Essa separação evita que a melhoria na experiência dos desenvolvedores seja confundida com uma liberação geral de ferramentas ofensivas.
O impacto da divisão entre IA pública e IA especializada em segurança
A estratégia da Anthropic evidencia um caminho possível para a próxima geração de assistentes de inteligência artificial. Modelos cada vez mais capazes de escrever código, operar terminais e interagir com infraestrutura também podem ser utilizados para descobrir vulnerabilidades e automatizar atividades ofensivas.
O desafio está em permitir que profissionais legítimos aproveitem essas capacidades sem disponibilizar ferramentas potencialmente perigosas para qualquer usuário.
O Claude Fable 5.2 procura resolver parte desse problema ao reduzir bloqueios desnecessários, enquanto o Claude Mythos 5.2 concentra recursos avançados de pesquisa em organizações verificadas.
Para desenvolvedores, administradores de sistemas e equipes de SecOps, a mudança pode representar uma experiência mais produtiva, especialmente em atividades que envolvem nuvem, automação e manutenção de ambientes complexos.
Ainda assim, os resultados divulgados são avaliações da própria Anthropic e precisam ser considerados dentro das condições específicas dos testes. A redução de falsos positivos não elimina a necessidade de revisão humana, controles de acesso e ambientes isolados.
A evolução desses modelos também levanta uma questão importante: até que ponto os assistentes de IA conseguem ajudar na administração de infraestrutura sem interpretar operações legítimas como ameaças?