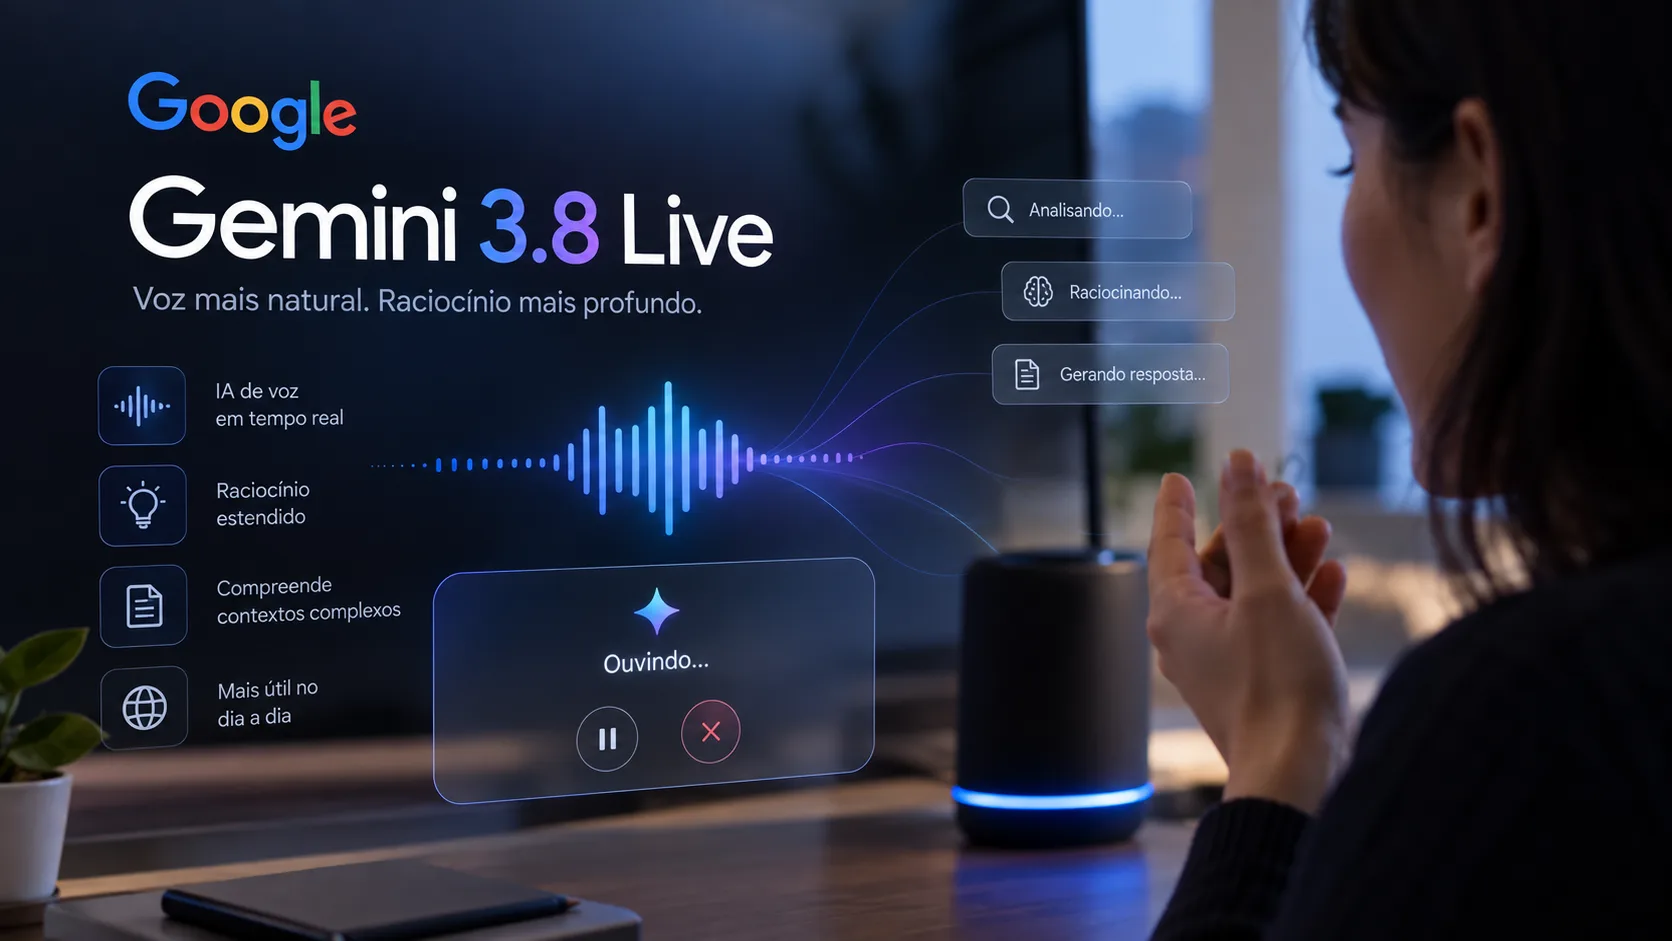
A Google anunciou o lançamento de dois novos modelos nativos de interação por voz: o Gemini 3.8 Live e o Gemini 3.8 Live Extended Thinking. Disponibilizados para desenvolvedores corporativos e integrados aos aplicativos da própria empresa, os modelos chegam para resolver um dos principais gargalos dos assistentes atuais: a quebra de fluidez durante a execução de tarefas complexas.
As novas versões consolidam a transição para modelos diretos de fala para fala, permitindo que a IA processe comandos, analise contexto visual, faça chamadas de API em segundo plano e responda em tempo real sem interrupções no fluxo do diálogo.
O que isso muda na prática
Para quem usa assistentes de voz, a mudança mais perceptível é o fim do “silêncio constrangedor” enquanto a máquina pesquisa ou processa uma solicitação pesada. O modelo Extended Thinking foi desenhado para processar dados e falar simultaneamente.Se o usuário pedir algo demorado, a IA utiliza marcadores conversacionais naturais; como “Deixe-me verificar isso”; e narra o progresso da tarefa passo a passo em vez de congelar.

Para os desenvolvedores de software e corporações, isso entrega a infraestrutura necessária para criar agentes virtuais capazes de consultar bancos de dados e realizar reservas em segundo plano sem que a ligação ou o atendimento pareçam artificiais ou desconectados.
Diferenças e especificações dos modelos
A Google dividiu o lançamento em duas frentes, adaptadas a diferentes necessidades de custo e poder computacional.
- Gemini 3.8 Live:Focado em escala e eficiência operacional, o modelo base combina inteligência conversacional com a capacidade de interpretar vídeo e imagens em tempo real. Ele consegue identificar e alternar instantaneamente entre 97 idiomas suportados, mesmo se o usuário trocar de língua no meio da frase.
- Gemini 3.8 Live Extended Thinking:Direcionado para fluxos de trabalho de alta complexidade, o modelo aplica raciocínio de múltiplas etapas. Segundo a empresa, ele lidera o índice Speech to Speech Quality Index da Artificial Analysis (pontuação de 82,6) e alcançou 97,7% no Big Bench Audio, métrica que avalia lógica em modelos sonoros.
Disponibilidade e ecossistema
Para os desenvolvedores, os modelos já estão operacionais via Gemini Live API e no Google AI Studio.O custo de operação via API foi definido em US$ 0,005 por minuto de entrada de áudio e US$ 0,018 por minuto de saída. Plataformas de desenvolvimento como LiveKit, LangChain e Vercel já oferecem suporte para simplificar a infraestrutura de streaming necessária.
No cenário de consumo, a Google iniciou o lançamento escalonado do Gemini 3.8 Live no Search Live, enquanto o modelo Extended Thinking será integrado ao aplicativo mobile do Gemini e às ferramentas do Google Workspace (como Gmail e Docs) para assinantes dos planos Pro e Ultra.
Em termos de segurança, todo o áudio gerado pelos novos modelos incorpora a tecnologia SynthID. Essa marca d’água imperceptível é fundida diretamente no arquivo sonoro, garantindo que sistemas de auditoria possam identificar o material como gerado por inteligência artificial para prevenir desinformação.