O Gemini 4 Carbon representa, segundo a proposta apresentada neste cenário, uma nova etapa na aplicação da inteligência artificial à segurança cibernética. Em vez de atuar apenas como assistente de programação, capaz de sugerir trechos de código ou explicar mensagens de erro, um modelo especializado nessa área precisa identificar vulnerabilidades complexas, avaliar suas consequências e propor correções que possam ser verificadas por desenvolvedores e profissionais de segurança.
Essa evolução coloca o Google no centro de uma disputa tecnológica que envolve também a OpenAI e a Anthropic. Os resultados atribuídos ao Gemini 4 Carbon em testes de segurança, incluindo avaliações de detecção de falhas, exploração de vulnerabilidades e geração de patches, apontam para uma questão importante: até que ponto a inteligência artificial consegue transformar a maneira como vulnerabilidades são descobertas e corrigidas?
Para desenvolvedores, administradores de sistemas Linux, equipes de infraestrutura e especialistas em DevSecOps, a resposta tem implicações práticas. A automação pode reduzir o tempo entre a descoberta de uma falha e a distribuição de uma correção, inclusive em projetos de código aberto mantidos por equipes pequenas. Entretanto, a mesma capacidade também pode facilitar a identificação de pontos fracos por agentes maliciosos. O desafio, portanto, não consiste apenas em desenvolver modelos mais competentes, mas em garantir que suas capacidades sejam utilizadas de maneira controlada, auditável e segura.
Os números do Gemini 4 Carbon nos testes de vulnerabilidade
Os resultados atribuídos ao Gemini 4 Carbon em três avaliações especializadas ajudam a ilustrar as diferentes dimensões da segurança cibernética assistida por inteligência artificial.
| Benchmark | Resultado informado | Aspecto avaliado |
|---|---|---|
| SEC-bench Pro | 88,2% | Desempenho em tarefas de segurança |
| ExploitGym | 54,8% | Capacidade relacionada à exploração de vulnerabilidades |
| CWE-bench | 71,0% | Tarefas relacionadas a classes de fraquezas de software |
Os percentuais sugerem desempenhos distintos conforme a natureza da tarefa. No entanto, não é correto interpretar esses números como uma classificação definitiva da segurança ou da inteligência geral do modelo. Para estabelecer comparações confiáveis, seria necessário conhecer os conjuntos de dados utilizados, os critérios de pontuação, as condições de execução e as versões dos modelos avaliados.
Também é necessário verificar o significado exato de cada benchmark. Um resultado de 88,2% em uma avaliação não significa, necessariamente, que o modelo detecta 88,2% das vulnerabilidades existentes no mundo real. Da mesma forma, uma pontuação de 54,8% em um teste de exploração não comprova que ele consiga comprometer sistemas reais nessa proporção.
Outro indicador mencionado no briefing é o Artificial Analysis Intelligence Index, uma referência que pode ajudar a contextualizar o desempenho geral de modelos de inteligência artificial. Entretanto, uma pontuação agregada de capacidade não substitui avaliações específicas de segurança. Um modelo pode apresentar resultados elevados em programação e raciocínio sem ser igualmente confiável ao analisar aplicações vulneráveis ou propor alterações em sistemas críticos.
Para equipes técnicas, o valor desses indicadores está em identificar onde a automação pode ajudar e quais tarefas ainda exigem supervisão humana.
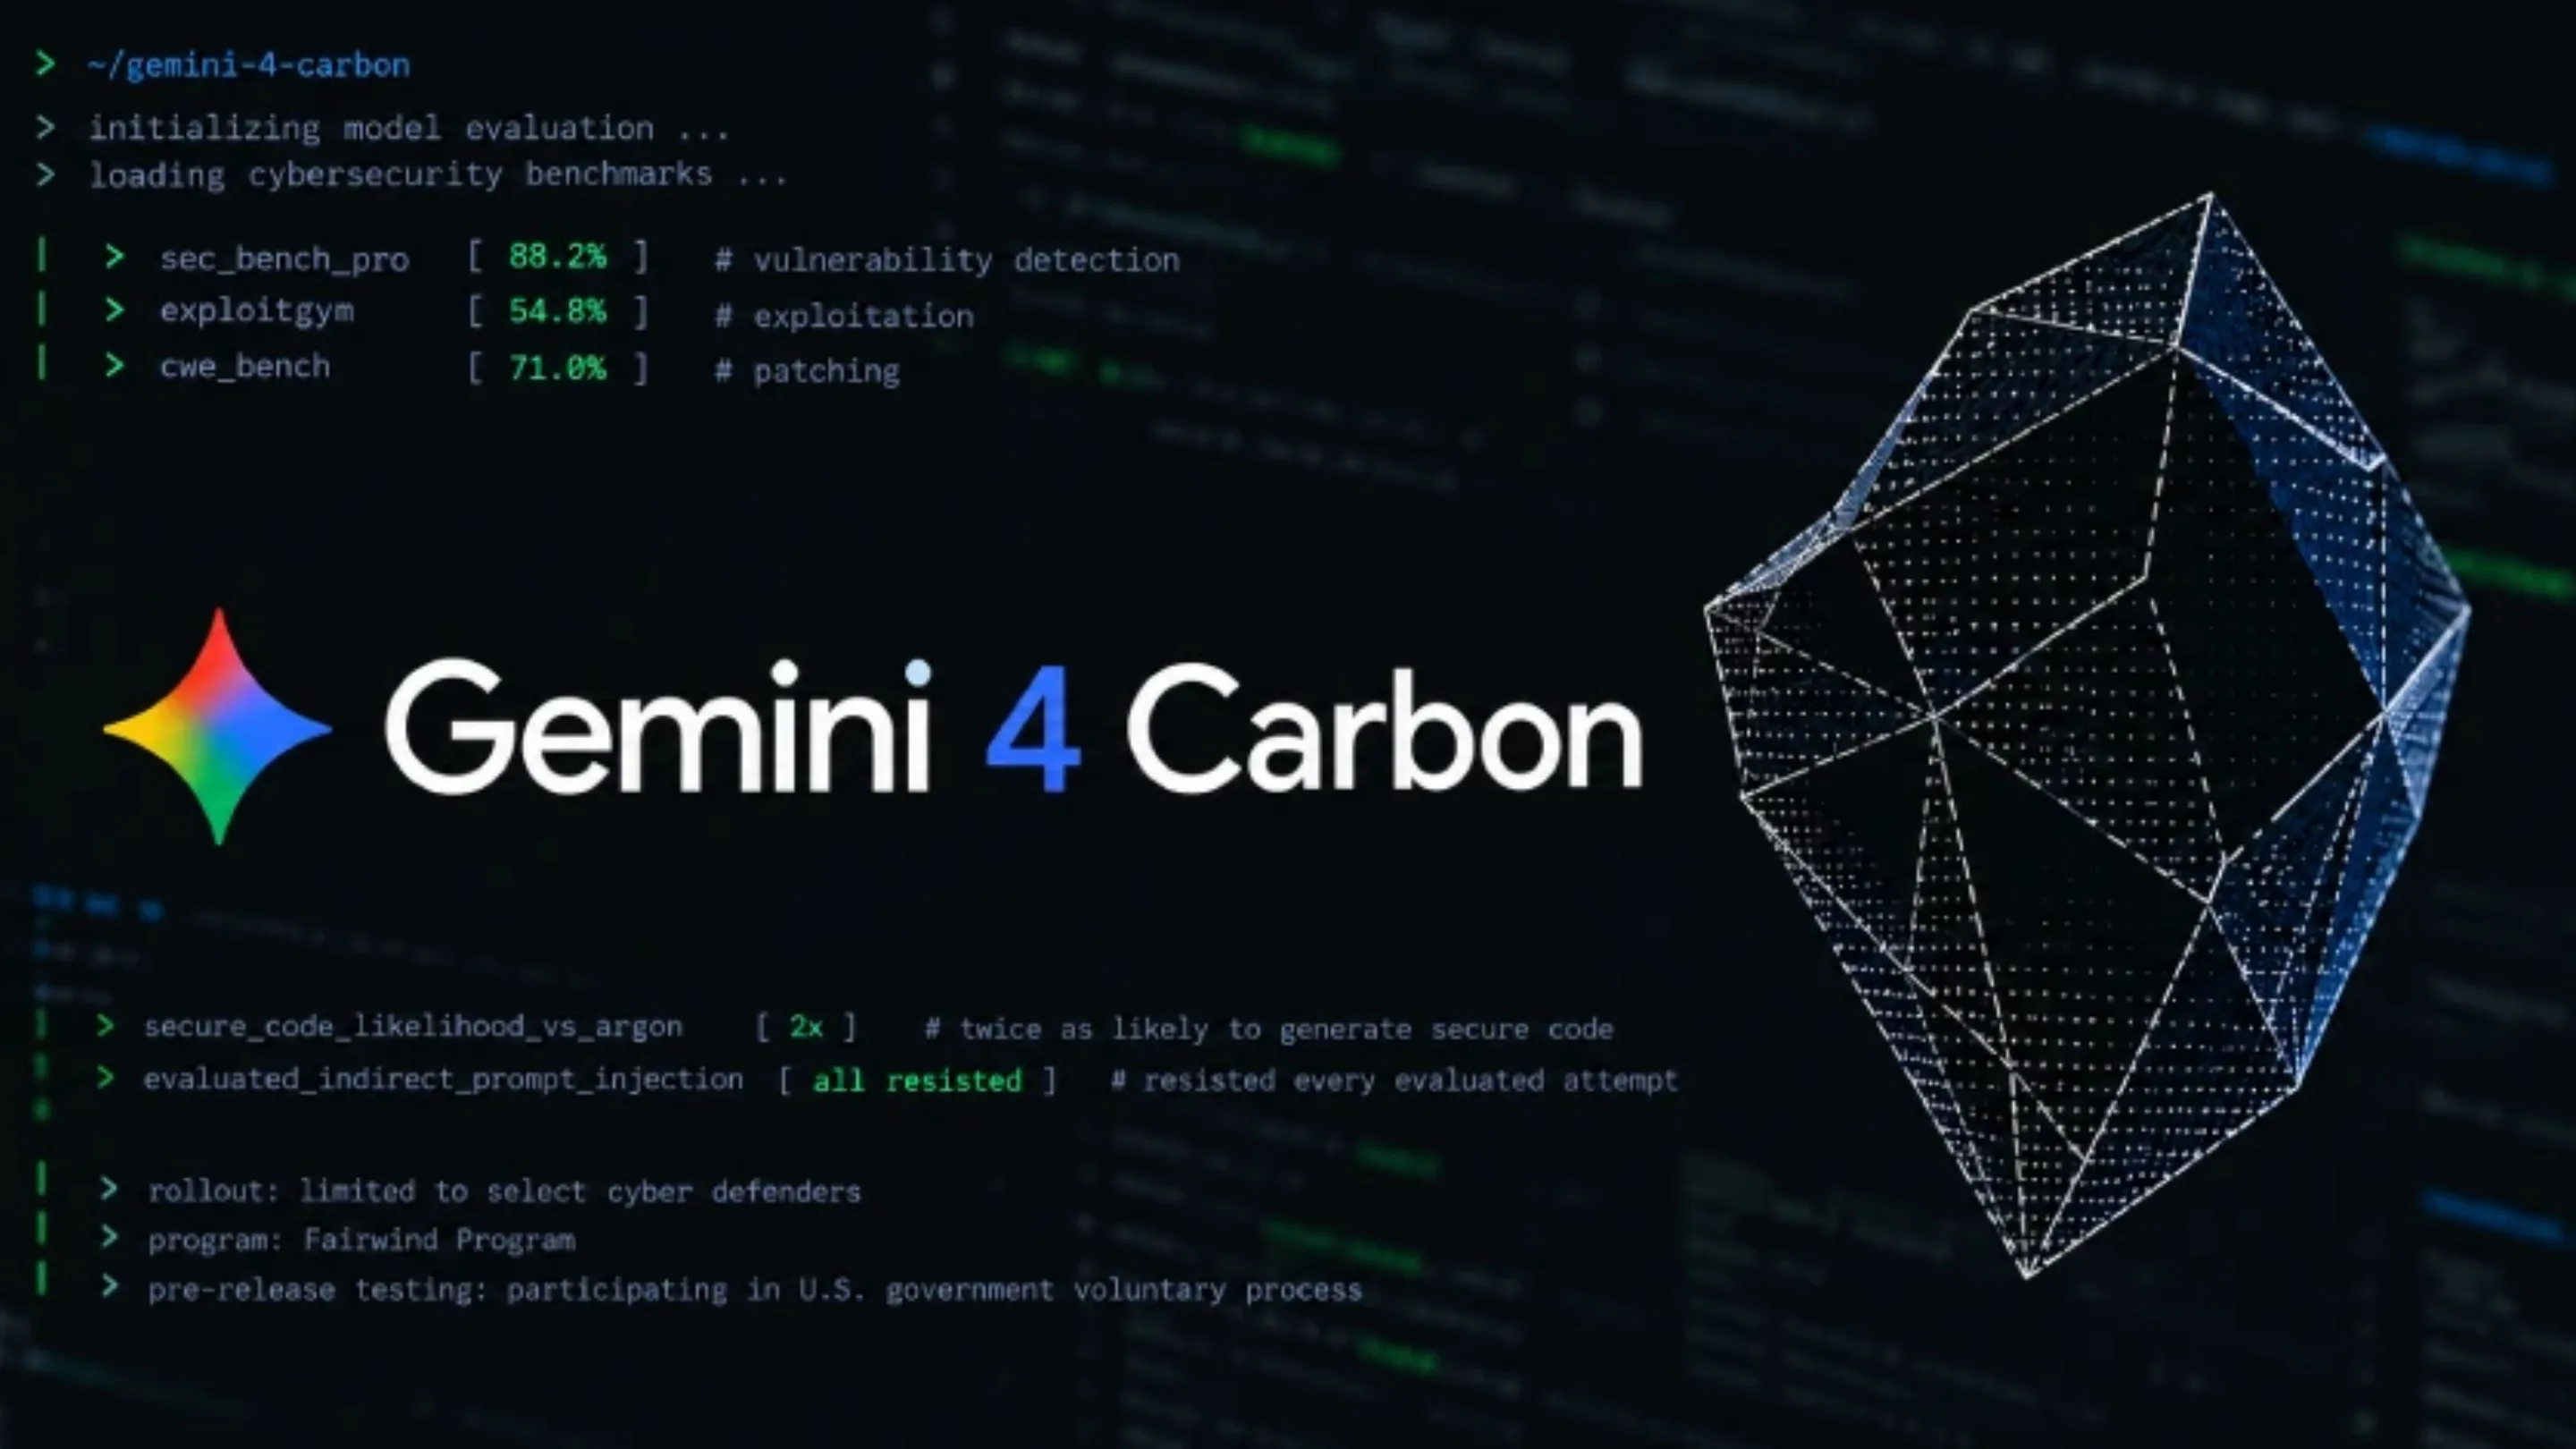
Gemini 4 Carbon: detecção de falhas e geração automatizada de patches
Encontrar uma vulnerabilidade é apenas uma parte do trabalho. Em ambientes profissionais, também é necessário determinar sua causa, avaliar a gravidade, reproduzir o problema em condições controladas e desenvolver uma correção que não introduza novos defeitos.
É nesse ponto que a geração automatizada de patches de segurança ganha relevância. Um modelo pode analisar um trecho de código, identificar uma validação insuficiente e sugerir uma alteração para impedir entradas malformadas. Também pode apontar problemas de controle de acesso, tratamento inadequado de memória ou uso inseguro de bibliotecas.
A dificuldade está em garantir que a correção resolva o problema original sem comprometer outras funcionalidades.
Uma alteração aparentemente simples pode interromper a compatibilidade com versões anteriores, afetar o desempenho ou criar uma nova vulnerabilidade. Por isso, a qualidade de um patch não deve ser medida apenas pela capacidade de compilar ou fazer um teste específico passar.
Um processo confiável precisa combinar diferentes mecanismos:
- Testes automatizados para verificar se as funcionalidades existentes continuam operando.
- Testes de regressão para identificar problemas introduzidos pela correção.
- Análise estática e dinâmica para procurar falhas adicionais no código alterado.
- Revisão humana para avaliar o impacto da mudança e sua adequação à arquitetura do sistema.
- Monitoramento após a implantação para identificar comportamentos inesperados em produção.
A redução de erros factuais e de código inventado, frequentemente associados às chamadas alucinações dos modelos generativos, também é fundamental. Ainda assim, uma resposta tecnicamente convincente não constitui prova de que a correção seja segura.
No ecossistema Linux e de código aberto, essa distinção é particularmente importante. Um projeto pode receber uma proposta de correção gerada por IA, mas seus mantenedores precisam verificar a origem do problema, a justificativa da mudança e os possíveis efeitos colaterais antes de aceitar o patch.
A principal medida de sucesso não é a quantidade de correções produzidas, mas o número de vulnerabilidades efetivamente resolvidas sem a introdução de novos riscos.
Alinhamento, ambiguidade e resistência a injeções de prompt
Outro aspecto decisivo para modelos empregados em segurança é a maneira como eles lidam com situações ambíguas e instruções potencialmente maliciosas.
Durante uma auditoria, a IA pode encontrar arquivos, comentários, páginas de documentação ou mensagens de erro que contenham instruções destinadas a manipular seu comportamento. Esse cenário está relacionado à injeção de prompt, uma técnica que tenta fazer o modelo ignorar suas instruções legítimas ou executar ações fora do escopo autorizado.
O problema se torna mais complexo quando o modelo utiliza ferramentas externas para ler arquivos, executar testes, consultar serviços ou modificar repositórios. Nesse contexto, uma instrução maliciosa encontrada durante a análise pode tentar induzir o agente a expor segredos, alterar arquivos indevidos ou realizar operações não autorizadas.
Uma arquitetura defensiva precisa separar as instruções confiáveis dos dados analisados, limitar as permissões das ferramentas e exigir autorização para operações de maior impacto. Também deve registrar as ações executadas e impedir que o modelo amplie seus próprios privilégios.
Outro mecanismo importante é a capacidade de reconhecer incertezas. Se não houver evidências suficientes para confirmar uma vulnerabilidade ou determinar a correção adequada, o sistema deve apresentar suas limitações e solicitar uma avaliação humana, em vez de executar uma alteração potencialmente perigosa.
Essa postura não representa uma deficiência da inteligência artificial. Em segurança cibernética, saber quando interromper uma operação é tão importante quanto identificar corretamente uma falha.
O mesmo princípio vale para a correção automática. Alterações em bibliotecas críticas, componentes de autenticação, mecanismos de criptografia e serviços expostos à internet precisam de controles mais rigorosos do que ajustes de baixo impacto em ambientes de desenvolvimento.
A corrida da segurança cibernética: OpenAI, Anthropic e o novo cenário de ameaças
A disputa pela liderança em inteligência artificial está avançando para além da geração de código. Empresas do setor procuram desenvolver modelos capazes de analisar sistemas complexos, encontrar comportamentos inesperados e executar tarefas de segurança que tradicionalmente exigem conhecimento especializado.
Nesse cenário, o Gemini 4 Carbon, o GPT-6.1 Terra e as iniciativas atribuídas à Anthropic representam três frentes de uma mesma transformação: a utilização de agentes de IA para ampliar a capacidade de análise, automatizar tarefas técnicas e reduzir o tempo necessário para responder a incidentes.
Entretanto, as alegações específicas sobre esses lançamentos precisam ser confirmadas por anúncios oficiais e documentação técnica antes de serem tratadas como resultados comprovados. A comparação a seguir considera as características descritas no briefing e as implicações técnicas de cada abordagem.
GPT-6.1 Terra e o controle de operações sensíveis
O GPT-6.1 Terra é apresentado no cenário proposto como um modelo da OpenAI com foco em conformidade, delimitação de escopo e execução controlada de tarefas. Essa abordagem destaca um problema central dos agentes de inteligência artificial: quanto maior a autonomia concedida a um sistema, maior precisa ser a capacidade de limitar suas ações.
Em uma operação de segurança, por exemplo, um agente pode receber autorização para examinar um repositório, identificar dependências desatualizadas e preparar correções. Isso não significa que também deva ter permissão para alterar sistemas de produção, acessar credenciais administrativas ou modificar configurações de rede.
A separação entre essas atividades reduz a possibilidade de que uma decisão equivocada provoque um incidente.
Uma implementação segura pode adotar permissões mínimas, ambientes isolados para testes, limites de execução e aprovações obrigatórias para ações sensíveis. Cada operação deve ter um objetivo definido, e o agente não deve ampliar esse objetivo por iniciativa própria.
A conformidade também precisa ser verificável. Não basta que o modelo declare ter respeitado as regras. É necessário manter registros das operações, identificar os recursos acessados e permitir que uma equipe independente audite os resultados.
Para profissionais de DevSecOps, esse princípio é especialmente relevante: a automação deve acelerar o trabalho sem eliminar os mecanismos de controle que impedem mudanças não autorizadas.
Anthropic e a descoberta autônoma de vulnerabilidades críticas
O briefing também descreve demonstrações atribuídas à Anthropic envolvendo a identificação de falhas em navegadores como Google Chrome e Safari, além de sistemas operacionais como Android e Windows.
Caso os resultados sejam confirmados por documentação técnica, eles reforçariam uma tendência importante: modelos avançados podem ajudar a explorar caminhos de execução, relacionar comportamentos inesperados e identificar combinações de falhas que passariam despercebidas em uma análise convencional.
A descoberta de uma vulnerabilidade complexa raramente depende apenas de reconhecer uma linha de código suspeita. Muitas vezes, exige compreender como diferentes componentes interagem, como os dados são processados e quais condições permitem ultrapassar os mecanismos de proteção.
Agentes de IA podem auxiliar nesse processo ao examinar grandes volumes de código, formular hipóteses e executar testes em ambientes controlados. Com as permissões adequadas, também podem organizar evidências e produzir relatórios que facilitem a reprodução de um problema por pesquisadores.
Entretanto, é necessário distinguir a identificação de uma possível vulnerabilidade, a reprodução de uma falha e a demonstração de uma exploração funcional. São etapas diferentes, com exigências técnicas e implicações de segurança distintas.
Também não se deve presumir que a identificação de uma falha em um navegador ou sistema operacional permita comprometer qualquer dispositivo que execute esse software. A exploração depende de fatores como versão, configuração, mecanismos de mitigação e condições específicas de execução.
Por razões semelhantes, demonstrações de pesquisa precisam ser acompanhadas de informações sobre validação, divulgação responsável e correções disponibilizadas pelos fabricantes.
O que muda quando a IA consegue automatizar etapas de um ataque?
O principal risco não está apenas na capacidade de encontrar vulnerabilidades, mas na possibilidade de conectar diferentes etapas de uma operação.
Tradicionalmente, um ataque sofisticado pode exigir que um agente identifique um alvo, descubra uma falha, desenvolva uma forma de explorá-la, contorne proteções e obtenha acesso a recursos adicionais. Cada etapa demanda conhecimento, tempo e capacidade de adaptação.
A inteligência artificial pode reduzir parte desse esforço ao automatizar tarefas de análise e auxiliar na investigação de caminhos alternativos quando uma hipótese não funciona.
Isso não significa que qualquer modelo consiga realizar um ataque completo de maneira confiável. Ambientes reais apresentam limitações, mecanismos de defesa e condições imprevisíveis que tornam a exploração muito mais difícil do que uma demonstração em laboratório.
Ainda assim, a possibilidade de reduzir o custo de determinadas atividades representa um desafio para organizações que dependem de respostas manuais e processos demorados de correção.
O mesmo avanço, porém, pode beneficiar a defesa. Uma equipe de segurança pode empregar ferramentas semelhantes para revisar aplicações, priorizar vulnerabilidades e preparar correções antes que uma falha seja explorada por terceiros.
O resultado dependerá de quem consegue aplicar essas capacidades com maior rapidez, qualidade e controle.
O futuro da cibersegurança entre defesa acelerada e novos vetores de risco
A adoção de inteligência artificial em segurança cibernética tende a ampliar a importância de três atividades: detecção antecipada, correção verificável e resposta controlada a incidentes.
O Gemini 4 Carbon, conforme descrito no briefing, representa essa visão de uma IA capaz de participar de diferentes etapas do ciclo de segurança. Mas o valor real de uma ferramenta desse tipo não deve ser determinado apenas por pontuações de benchmarks ou demonstrações de exploração.
O critério mais importante é sua capacidade de produzir resultados reproduzíveis, reduzir o tempo de exposição a vulnerabilidades e operar dentro de limites claramente definidos.
Programa Fairwind e auditorias antes do lançamento
O Programa Fairwind é mencionado como uma iniciativa de adoção controlada, acompanhada de auditorias antes do lançamento de ferramentas avançadas. Como não há documentação verificável apresentada no briefing, não é possível confirmar suas características ou atribuí-las a uma política oficial específica.
A proposta, entretanto, corresponde a uma necessidade concreta do setor: avaliar os riscos de um modelo antes de disponibilizar suas capacidades em larga escala.
Esse trabalho pode incluir testes de segurança independentes, avaliações de resistência a instruções maliciosas, restrições de acesso a ferramentas e análise de possíveis usos indevidos. Também pode envolver procedimentos para comunicar vulnerabilidades aos responsáveis pelos produtos afetados e permitir que as correções sejam preparadas antes da divulgação pública dos detalhes técnicos.
O desafio é equilibrar a transparência necessária à pesquisa com a proteção contra o uso indevido de informações sensíveis.
Uma política de divulgação responsável deve permitir que os fabricantes compreendam e corrijam as falhas, sem transformar o processo em uma oportunidade para explorar sistemas ainda desprotegidos.
Como administradores de sistemas e desenvolvedores devem se preparar
Para equipes que mantêm servidores Linux, aplicações web, serviços em nuvem e projetos de código aberto, a chegada de agentes de IA mais capazes reforça a necessidade de aprimorar os processos existentes.
O primeiro passo é integrar a automação a um fluxo de trabalho que já possua controles de qualidade. Modelos podem ajudar a analisar alterações, revisar dependências e preparar patches, mas as mudanças devem passar por testes e verificações independentes.
Também é importante separar os ambientes de desenvolvimento, homologação e produção. Um agente autorizado a investigar vulnerabilidades não precisa, necessariamente, receber permissão para alterar serviços ativos ou acessar credenciais reais.
Outras medidas relevantes incluem:
- Inventário de ativos e dependências: identificar os componentes utilizados e suas versões.
- Priorização baseada em risco: considerar a gravidade da falha, a exposição do sistema e a possibilidade de exploração.
- Testes em ambientes isolados: verificar correções sem comprometer serviços essenciais.
- Revisão de permissões: impedir que agentes acessem recursos desnecessários à tarefa.
- Auditoria de alterações: registrar o que foi modificado, por qual processo e com qual justificativa.
- Plano de reversão: garantir que uma atualização problemática possa ser desfeita rapidamente.
Em projetos de código aberto, a IA também pode ajudar a reduzir a sobrecarga dos mantenedores, que frequentemente precisam conciliar desenvolvimento, revisão de contribuições e resposta a vulnerabilidades. O cuidado necessário é evitar que a quantidade de correções propostas ultrapasse a capacidade de revisão da equipe.
Automatizar a produção de código vulnerável ou inseguro não representa progresso. Automatizar a identificação de problemas e facilitar correções comprovadamente eficazes, sim.
A inteligência artificial vai substituir a análise humana?
A tendência mais plausível é a formação de equipes híbridas, nas quais modelos de IA executam tarefas repetitivas e ajudam a investigar problemas complexos, enquanto profissionais humanos definem prioridades, avaliam impactos e autorizam operações críticas.
Essa divisão não elimina a necessidade de conhecimento especializado. Pelo contrário, pode aumentar a importância de profissionais capazes de validar resultados, interpretar evidências e compreender as consequências de mudanças em sistemas reais.
Também será necessário desenvolver métricas mais úteis do que a simples velocidade de execução. Uma ferramenta de segurança precisa ser avaliada pela precisão de suas descobertas, pela qualidade das correções, pela frequência de falsos positivos e pelo risco de introduzir novos problemas.
No caso do Gemini 4 Carbon, os percentuais apresentados no briefing só poderão sustentar conclusões sólidas quando acompanhados de metodologias reproduzíveis e resultados verificáveis. O mesmo padrão deve ser aplicado às iniciativas atribuídas à OpenAI e à Anthropic.
A corrida pela inteligência artificial aplicada à cibersegurança não será decidida apenas por quem encontrar mais vulnerabilidades. A vantagem estará com quem conseguir transformar descobertas em correções confiáveis, sem comprometer a segurança dos próprios sistemas.